引言
人工智能的浪潮正以前所未有的速度重塑世界,而算力则是驱动这一浪潮的核心引擎。在以GPU为代表的高端AI芯片领域,国际出口管制不断升级,形成了严峻的“算力封锁”。中国AI产业要高速发展,必须攻克国产GPU的算力瓶颈。谁能担此重任?答案不仅在于硬件本身的突破,更在于人工智能基础软件的协同创新。
一、算力封锁的现实与国产GPU的使命
美国对华高端GPU(如NVIDIA A100/H100等)的出口限制,使国内AI大模型训练面临算力紧缺。国产GPU企业如壁仞科技、摩尔线程、天数智芯、寒武纪、海光信息等纷纷发力,试图填补这一空白。它们的目标不是简单复刻国际巨头,而是要在架构、生态、软件栈上走出一条自主之路。
GPU的成功从来不是单点硬件突破。国际龙头NVIDIA的强大,一半来自CUDA生态。国产GPU若只靠硬件算力提升,而缺乏匹配的人工智能基础软件,就无法让开发者“用得起来”,也就无法真正推动AI高速发展。
二、基石:人工智能基础软件开发
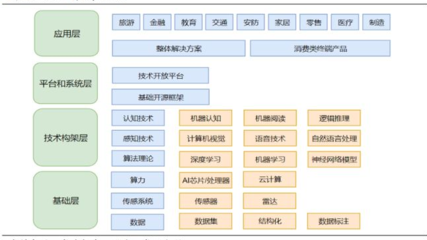
人工智能基础软件是连接上层AI框架(PyTorch、TensorFlow、PaddlePaddle等)和底层芯片的桥梁,主要包括:
- 编程模型与编译器:如针对国产GPU的并行计算语言、LLVM/MLIR后端优化,将AI算子高效映射到硬件。
- 算子库与通信库:定制高性能算子(矩阵乘、卷积、注意力等)及集合通信库(类似NCCL),支持大规模分布式训练。
- AI框架适配层:让主流框架无缝支持国产GPU,降低迁移成本。
- 推理引擎与部署工具:如OpenVINO、TensorRT的替代方案,实现端到端优化。
没有这些基础软件,国产GPU就是“有硬无软”的空壳,无法被AI开发者接纳翻译成实际生产力。
三、谁能突破?硬软协同的先行者
- 壁仞科技:其BR100系列GPU强调算力对标国际,同时自研BIRENSUPA软件平台,试图构建从编译器到框架适配的完整栈。
- 摩尔线程:MUSA统一系统架构覆盖图形与计算,提供 musify 迁移工具,帮助CUDA应用低成本移植,生态思路清晰。
- 华为昇腾:虽然并非传统GPU,但其CANN基础软件栈和MindSpore框架形成硬软一体,是国产AI基础软件的成功范例,为GPU厂商提供参考。
- 寒武纪:早期以思元芯片+Cambricon Neuware软件栈著称,积累了较强的编译器与库能力。
- 天数智芯:天垓训练卡与智铠推理卡配合自研软件栈,注重框架兼容。
真正的突破者将是那些敢于在编译器、算子库、分布式训练框架上长期投入,并开放生态、拥抱开源(如与PyTorch、PaddlePaddle社区深度合作)的企业。单纯堆砌硬件算力,无法打破封锁。
四、推动中国AI高速发展的路径
- 软硬协同设计:GPU架构需针对AI负载优化,同时软件提前介入,实现“设计即支持”。
- 开源开放生态:联合发起国产AI基础软件开源项目,吸引全球开发者,避免重复造轮子。
- 标准与接口统一:避免各厂商私有多套软件栈造成的碎片化。通过联盟推动统一编程接口和算子标准。
- 人才培养与社区运营:CUDA的护城河本质是开发者习惯。国产GPU必须投入大量资源做培训、文档、示例、竞赛。
- 政策与产业协同:国家专项支持基础软件研发,鼓励AI企业试用国产算力,形成反馈闭环。
五、
国产GPU突破算力封锁,不是一场简单的芯片竞赛,而是一场硬件、基础软件、开发者生态的系统性战役。谁能率先构建起好用、易用、开放的AI基础软件平台,谁就能真正将国产GPU的算力转化为中国AI高速发展的动力。这条路没有捷径,但每一步扎实的软件创新,都在为最终破局铺路。未来已来,只待硬软同心的突围者。